点击右上角 微信好友
 朋友圈
请使用浏览器分享功能进行分享
10月18日,以“超智深融 算力圳浓”为主题的2026 CCF全国高性能计算学术大会在深圳举行。其间,联想以“混合词元工厂”为主线,集中展示万全异构智算、海神液冷、超节点等算力解决方案,系统呈现了AI时代联想基础设施的前沿技术与创新成果。
联想集团首席科学家肖利民围绕《存算融合加速大模型推理的探索实践》发表演讲,系统介绍了联想在CXL内存池与近存计算融合方面的技术创新,为降低Token综合成本提供了参考路径。
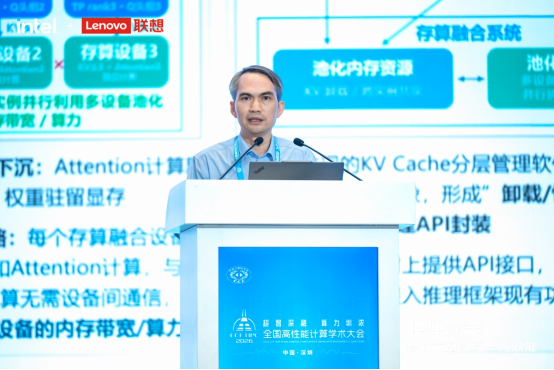
联想集团首席科学家肖利民
随着Agentic AI加速落地,大模型应用正从单一的对话工具走向具备感知、规划与执行能力的智能体,AI算力需求也从训练进一步向推理延伸。市场研究机构Fortune Business Insights预测,全球AI推理市场规模将从2026年的约1178亿美元增长至2034年的约3126亿美元。
但大模型推理市场高速增长的背后,技术性能瓶颈日益凸显,推理请求和上下文长度不断增加,使模型运行过程中产生的KV Cache快速增长。有限的GPU显存难以兼顾模型权重、KV Cache存储和高并发推理;转存至主机内存,又会面临访问带宽不足、延迟较高等问题,如何拓展KV Cache存储可用容量、降低访存开销,成为大模型推理基础设施亟待解决的关键问题。
针对这一挑战,肖利民系统分享了联想在内存扩展与近存计算融合方面的探索实践。一方面,基于CXL内存池扩展可用内存容量,让KV Cache能够分层存储,并支持多个推理实例共享公共前缀,减少重复存储和重算;另一方面,在内存侧配置近存计算引擎,将Attention等适合的计算任务与KV数据一起下沉至内存侧,借助近存计算让数据就近处理、减少KV跨设备搬运,从而破解“内存墙”问题。
肖利民表示,验证数据表明,存算融合推理加速系统可显著降低大模型推理延迟,大幅提升系统吞吐量。分项验证中,对比NVMe层,内存池在固定输入长度场景TTFT降低3.5倍,在多轮对话场景TTFT降低2.4倍,且随着对话轮次变多,延迟上涨幅度相对平缓,优势更加明显。
借助内存池实现KV复用,相比完全重计算,首Token延迟加速12至28倍;对比RDMA架构内存池,也可以实现2至3倍的加速。把注意力计算下沉内存池侧,解码延迟降低约2.5倍,同时腾出大量显存,可用于支持更长上下文、更大规模模型。
端到端推理延迟方面,与RDMA内存池基线对比,取得了2至3倍的端到端加速,且上下文越长,加速效果越明显;系统吞吐量提升更加可观,随着上下文变长,系统吞吐量提升6至20倍。
活动现场,联想正式发布聚焦词元工厂、海神液冷、AI存储的三卷《联想算力基础设施差异化优势非凡箓》,并重点展示的绿色液冷落地技术与前沿方案。
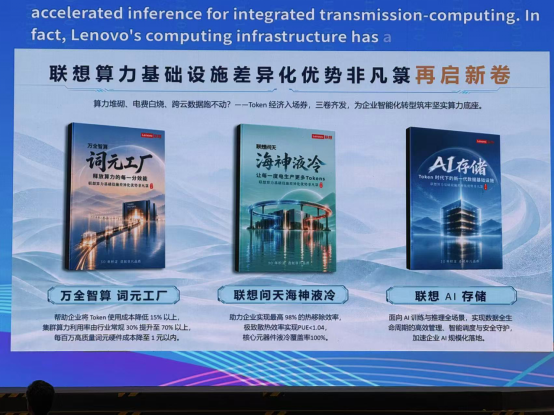
据介绍,目前,海神液冷技术解决方案已在多个重点行业应用落地。在制造领域,联想基于海神温水水冷高性能计算解决方案,构建了吉利星睿智算中心·智能仿真平台,为车型研发提供强劲算力支持,该平台可支持吉利汽车开展超1.2万次全场景虚拟碰撞试验、超过72万公里的虚拟道路耐久测试,并大幅提升研发仿真计算效率,数据中心PUE为1.1062,一年满负荷运行可减少约3179吨碳排放。
在教育领域,联想面向教科研HPC和AI4S混合场景,实现HPC与AI异构算力融合,提升CPU、GPU资源利用率,解决数据共享难题,支撑了辽宁大学、上海交通大学等众多高校在科学前沿领域的研究。
在气象领域,联想为北京气象局搭建了由800台服务器组成的温水水冷高性能计算系统,支持7×24小时天气、气候和环境气象业务,这一系统曾服务北京冬奥会的气象保障,支撑了分钟级、百米级的气象预报需求。(鸣耒)
乘“蛟龙”入深海
西藏山南萨热路跨江大桥全线合龙